
Attention is all you need
transformer는 시퀀스 데이터 처리를 맡아오던 순환 신경망(RNN)과 합성곱 신경망(CNN)의 한계를 넘기 위해 나온 구조이다. 순환 신경망은 단어를 한 단계씩 순서대로 처리해야 해서 병렬 연산이 안 됐고, 입력이 길어질수록 앞쪽 정보가 사라지는 문제도 있었다. transformer는 순환 연산을 아예 없애고 attention만으로 시퀀스 전체를 한 번에 병렬 처리한다. 덕분에 단어 사이의 거리와 상관없이 두 단어를 직접 연결할 수 있고, 지금은 GPT, Claude, Gemini 같은 LLM의 기본 구조가 되었다.
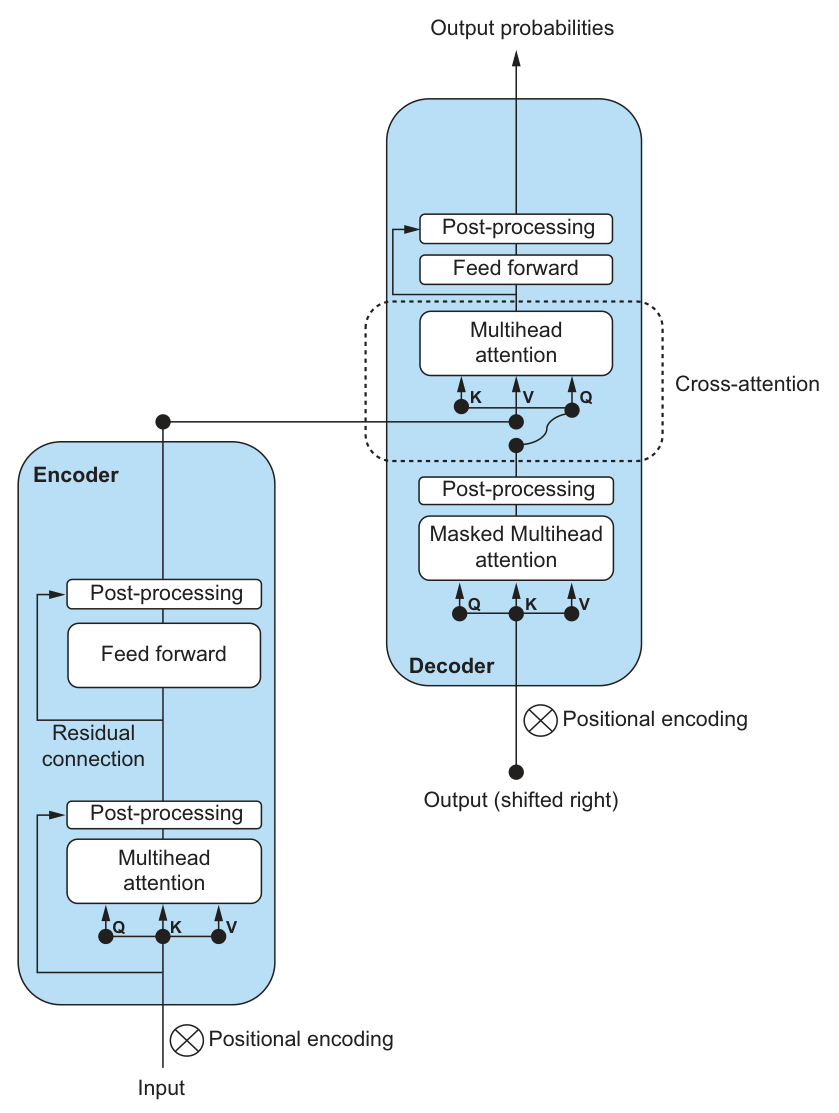
출처: Richard Heimann, Sutskever’s List (Manning), Figure 5.1
토큰화, 임베딩, 위치 인코딩
토큰화와 임베딩
transformer에 들어가는 문장은 먼저 서브워드 단위의 토큰으로 나뉘고, 각 토큰은 고유한 정수 ID로 바뀐다. 서브워드는 단어 전체를 통째로 다루지 않고 그보다 작은 조각으로 쪼갠 단위이다. 접두사, 접미사, 어근 같은 것을 떠올리면 된다. 이 토큰 ID는 학습 가능한 임베딩 테이블을 거쳐 고차원 벡터로 바뀌는데, 원본 논문의 base 모델에서는 512차원이다.
이 과정을 흔히 임베딩이라고 부른다.
위치 인코딩
transformer는 시퀀스 전체를 동시에 입력받기 때문에, 순환 신경망과 달리 단어의 위치를 스스로 알지 못한다. 어텐션 연산만으로는 단어 순서가 바뀐 문장을 구분할 수 없어서, 각 토큰의 임베딩 벡터에 위치 인코딩(positional encoding) 벡터를 직접 더해준다. 논문에서는 주기가 서로 다른 sin과 cos 함수로 위치 인코딩을 만들었다.
위치 인코딩이 필요한 이유
RNN은 문장을 첫 단어부터 마지막 단어까지 한 단어씩 차례로 읽기 때문에, 구조 자체가 순서를 자연스럽게 반영한다.
반면 transformer는 문장 전체를 한 번에 병렬로 처리한다.
예를 들어
- I love cats
- cats love I 두 문장이 있다고 하자. 셀프 어텐션(self-attention)은 단어 벡터끼리의 행렬 곱(내적)으로 유사도를 계산한다. 순서 정보가 따로 없으면 I와 cats 사이의 계산과 cats와 I 사이의 계산이 똑같이 처리된다. 단어 위치가 바뀌어도 모델이 보는 수학적 표현이 같아지는 것이다.
그래서 단어의 의미를 담은 임베딩 벡터에, 위치를 나타내는 고유한 벡터를 1:1로 더해준다. 이것이 위치 인코딩이다.
위치 벡터는 주기가 다른 sine과 cosine 함수로 만든다. 차원이 짝수인지 홀수인지에 따라 쓰는 식이 다르다.
삼각함수 기반 위치 인코딩 수식
-
짝수 차원에는 sine을 쓴다. \(\text{PE}_{(pos, 2i)} = \sin\left(\frac{pos}{10000^{2i / d_{\text{model}}}}\right)\)
-
홀수 차원에는 cosine을 쓴다. \(\text{PE}_{(pos, 2i+1)} = \cos\left(\frac{pos}{10000^{2i / d_{\text{model}}}}\right)\)
$pos$: 문장 내에서 단어의 위치 (0번째, 1번째, 2번째 …)
$i$: 벡터 내부의 차원 인덱스 (0번째 차원, 1번째 차원, 2번째 차원 …)
$d_{\text{model}}$: 단어 임베딩 벡터의 전체 차원 수
pos가 커질수록 각 차원에서 일정한 패턴으로 값이 변한다. 모델은 이 변화를 보고 단어의 절대적 위치(absolute position)와 상대적 거리(relative distance)를 모두 파악할 수 있다.
토큰화, 임베딩, 위치 인코딩 수치 계산 시뮬레이션
직접 계산해 보자.
문장은 “I love cats”이고, 계산이 간단하도록 벡터 차원을 4로 줄인다. 위치 인덱스(pos)는 다음과 같다.
- “I” -> pos = 0
- “love” -> pos = 1
- “cats” -> pos = 2
먼저 임베딩이다. 학습으로 정해지는 값이지만 여기서는 임의의 4차원 벡터를 가정한다.
- “I” (pos=0) = $[0.10, \ 0.20, \ 0.30, \ 0.40]$
- “love” (pos=1) = $[0.50, \ 0.60, \ 0.70, \ 0.80]$
- “cats” (pos=2) = $[0.90, \ 0.10, \ 0.20, \ 0.30]$
이제 위 삼각함수 공식으로 위치 인코딩 벡터를 계산한다.
- 차원 인덱스 $i=0$ 일 때: 0번째 차원(짝수, $\sin$), 1번째 차원(홀수, $\cos$)
- 차원 인덱스 $i=1$ 일 때: 2번째 차원(짝수, $\sin$), 3번째 차원(홀수, $\cos$)
계산된 위치 인코딩 값(소수점 셋째 자리 반올림)은 다음과 같다.
- 0번째 단어 I ($pos=0$)의 위치 벡터:
- 0번째 차원: $\sin(0 / 10000^0) = \sin(0) = 0.00$
- 1번째 차원: $\cos(0 / 10000^0) = \cos(0) = 1.00$
- 2번째 차원: $\sin(0 / 10000^{0.5}) = \sin(0) = 0.00$
- 3번째 차원: $\cos(0 / 10000^{0.5}) = \cos(0) = 1.00$
- $\text{PE}(pos=0) = [0.00, \ 1.00, \ 0.00, \ 1.00]$
- 1번째 단어 love ($pos=1$)의 위치 벡터:
- 0번째 차원: $\sin(1 / 1) = \sin(1) \approx 0.84$
- 1번째 차원: $\cos(1 / 1) = \cos(1) \approx 0.54$
- 2번째 차원: $\sin(1 / 100) = \sin(0.01) \approx 0.01$
- 3번째 차원: $\cos(1 / 100) = \cos(0.01) \approx 1.00$
- $\text{PE}(pos=1) = [0.84, \ 0.54, \ 0.01, \ 1.00]$
- 2번째 단어 cats ($pos=2$)의 위치 벡터:
- 0번째 차원: $\sin(2 / 1) = \sin(2) \approx 0.91$
- 1번째 차원: $\cos(2 / 1) = \cos(2) \approx -0.42$
- 2번째 차원: $\sin(2 / 100) = \sin(0.02) \approx 0.02$
- 3번째 차원: $\cos(2 / 100) = \cos(0.02) \approx 1.00$
- $\text{PE}(pos=2) = [0.91, \ -0.42, \ 0.02, \ 1.00]$
transformer에 실제로 들어가는 벡터는 [단어 임베딩] + [위치 인코딩]이다. 같은 차원끼리 더하면 된다.
- I 의 최종 입력 벡터:
\([0.10, \ 0.20, \ 0.30, \ 0.40] + [0.00, \ 1.00, \ 0.00, \ 1.00] = [0.10, \ 1.20, \ 0.30, \ 1.40]\) - love 의 최종 입력 벡터:
\([0.50, \ 0.60, \ 0.70, \ 0.80] + [0.84, \ 0.54, \ 0.01, \ 1.00] = [1.34, \ 1.14, \ 0.71, \ 1.80]\) - cats 의 최종 입력 벡터:
\([0.90, \ 0.10, \ 0.20, \ 0.30] + [0.91, \ -0.42, \ 0.02, \ 1.00] = [1.81, \ -0.32, \ 0.22, \ 1.30]\)
이렇게 만들어진 벡터가 모델에 입력된다.
이후에는 이 방식이 학습형 위치 임베딩, 상대 위치 임베딩, 그리고 LLaMA 등에서 쓰는 회전 위치 임베딩(RoPE)으로 발전했다.
인코더 구조와 Query, Key, Value 셀프 어텐션
인코더 및 셀프 어텐션
토큰화, 임베딩, 위치 인코딩으로 전처리한 데이터가 모델에 들어오면, 이제부터 본격적인 계산이 시작된다.
인코더는 입력 토큰 시퀀스를 문맥이 충분히 반영된 벡터로 바꾸는 역할을 한다. 인코더 안의 셀프 어텐션(Self Attention)은 한 시퀀스 안의 모든 토큰이 서로를 참조해 관계 가중치를 계산하는 연산이다.
셀프 어텐션에서는 각 토큰의 512차원 벡터에 학습 가능한 가중치 행렬 세 개를 각각 곱해서 쿼리(Query, Q), 키(Key, K), 밸류(Value, V) 벡터를 만든다. 쿼리는 현재 토큰이 다른 토큰에게서 얻고 싶은 정보의 기준이고, 키는 각 토큰이 가진 식별 정보이며, 밸류는 실제로 다른 토큰에 전달할 내용이다.
어텐션 계산식은 $\text{Attention}(Q, K, V) = \text{softmax}\left(\frac{QK^T}{\sqrt{d_k}}\right)V$ 이다. 먼저 쿼리 행렬(Q)과 키 행렬의 전치($K^T$)를 곱해 모든 토큰 쌍의 유사도 점수를 구한다. 이 값을 키 벡터 차원 $d_k$의 제곱근($\sqrt{d_k}$)으로 나눠 스케일링한다. 차원이 커질수록 내적 값이 너무 커져서 softmax의 기울기가 소실되는 것을 막기 위해서이다. 스케일링한 점수는 softmax를 거쳐 합이 1인 가중치가 되고, 이 가중치를 밸류 행렬($V$)에 곱해 가중합을 구하면 각 토큰의 문맥이 반영된 표현이 나온다.
셀프 어텐션의 5단계 연산 과정
조금 더 풀어서 보면,
셀프 어텐션의 목적은 단어별 벡터를 받아서 시퀀스 안의 다른 모든 단어와의 연관성을 가중치로 계산하고, 그걸 반영한 문맥 벡터를 만드는 것이다.
- 먼저 입력 행렬 ($X$)을 구성한다.
입력 시퀀스의 토큰 개수를 $N$, 각 토큰의 임베딩 차원을 $d_{\text{model}}$이라 한다.
입력 행렬 $X$의 크기는 $(N \times d_{\text{model}})$이다.
- $Q, K, V$ 투영 변환한다.
입력 $X$에 학습 가능한 가중치 행렬 $W^Q, W^K, W^V$를 각각 곱하여 $Q, K, V$ 행렬을 만든다. $W^Q, W^K$의 크기는 $(d_{\text{model}} \times d_k)$ 이고, $W^V$의 크기는 $(d_{\text{model}} \times d_v)$이다.
투영된 결과는 다음과 같다.
- $Q = X W^Q$ (크기: $N \times d_k$): 각 토큰이 연산을 일으킬 기준값
- $K = X W^K$ (크기: $N \times d_k$): 각 토큰이 비교당할 기준값
- $V = X W^V$ (크기: $N \times d_v$): 실제로 전달할 정보값
- 위에서 구한 Q, K, V를 활용하여 유사도 점수를 계산한다. ($Q K^T$)
$Q$와 $K^T$를 행렬곱하면 $(N \times N)$ 크기의 행렬이 나온다. $(i, j)$번째 원소는 $i$번째 토큰의 Query와 $j$번째 토큰의 Key를 내적한 값이고, 클수록 두 벡터의 방향이 비슷하다, 즉 두 토큰이 더 유사하다는 뜻이다.
연산 차원: $(N \times d_k) \times (d_k \times N) = (N \times N)$
- 스케일링 및 소프트맥스 ($\text{softmax}(Q K^T / \sqrt{d_k})$)
내적 값을 $\sqrt{d_k}$로 나눈다. $d_k$가 커질수록 내적의 절댓값이 매우 커져서 softmax에서 기울기 소실(Gradient Vanishing)이 생기는데, 이를 막기 위해서이다.
스케일링한 $(N \times N)$ 행렬의 각 행에 softmax를 적용하면 각 행의 값은 0 이상 1 이하가 되고 합은 정확히 1이 된다. 이 행렬이 어텐션 가중치(Attention Weight) 행렬이다.
- 가중합 계산 (최종 출력 $Z$)
어텐션 가중치 행렬 $(N \times N)$과 $V$ 행렬 $(N \times d_v)$을 곱한다. 결과 $Z = \text{Attention}(Q, K, V)$의 크기는 $(N \times d_v)$이고, 각 토큰 위치에는 시퀀스 전체의 $V$ 벡터가 어텐션 가중치 비율대로 섞인 문맥 표현이 담긴다.
다섯 단계를 그림으로 정리하면 다음과 같다.
flowchart LR
    X["입력 X<br>(N × d<sub>model</sub>)"] -- "W<sup>Q</sup>" --> Q["Q"]
    X -- "W<sup>K</sup>" --> K["K"]
    X -- "W<sup>V</sup>" --> V["V"]
    Q --> S["QK<sup>T</sup><br>(N × N)"]
    K --> S
    S --> SC["÷ √d<sub>k</sub>"]
    SC --> SM["softmax<br>(행 단위)"]
    SM --> Z["가중합<br>Z (N × d<sub>v</sub>)"]
    V --> Z
셀프 어텐션 수치 계산 시뮬레이션
이것도 직접 계산해 보자.
조건은 다음과 같이 가정한다.
- 토큰 개수 $N = 2$ (토큰 1, 토큰 2)
- 임베딩 차원 $d_{\text{model}} = 2$
- $K, Q$ 차원 $d_k = 2$
- $V$ 차원 $d_v = 2$
1단계: 투영된 $Q, K, V$ 행렬
가중치 행렬을 곱해서 나온 $Q, K, V$가 아래와 같다고 하자.
\[Q = \begin{bmatrix} 1.0 & 0.0 \\ 0.0 & 2.0 \end{bmatrix} \quad (\text{행 1: 토큰 1의 } Q, \text{ 행 2: 토큰 2의 } Q)\] \[K = \begin{bmatrix} 1.0 & 2.0 \\ 0.0 & 1.0 \end{bmatrix} \quad (\text{행 1: 토큰 1의 } K, \text{ 행 2: 토큰 2의 } K)\] \[V = \begin{bmatrix} 0.5 & 1.5 \\ 2.0 & 0.0 \end{bmatrix} \quad (\text{행 1: 토큰 1의 } V, \text{ 행 2: 토큰 2의 } V)\]2단계: 유사도 내적 점수 계산 ($Q K^T$)
$K$의 전치 행렬 $K^T = \begin{bmatrix} 1.0 & 0.0 \ 2.0 & 1.0 \end{bmatrix}$를 구해 $Q$와 곱한다.
\[Q K^T = \begin{bmatrix} 1.0 & 0.0 \\ 0.0 & 2.0 \end{bmatrix} \begin{bmatrix} 1.0 & 0.0 \\ 2.0 & 1.0 \end{bmatrix} = \begin{bmatrix} 1.0 \cdot 1.0 + 0.0 \cdot 2.0 & 1.0 \cdot 0.0 + 0.0 \cdot 1.0 \\ 0.0 \cdot 1.0 + 2.0 \cdot 2.0 & 0.0 \cdot 0.0 + 2.0 \cdot 1.0 \end{bmatrix} = \begin{bmatrix} 1.0 & 0.0 \\ 4.0 & 2.0 \end{bmatrix}\]- 1행 $[1.0, 0.0]$: 토큰 1의 $Q$와 (토큰 1의 $K$, 토큰 2의 $K$)의 내적 값
- 2행 $[4.0, 2.0]$: 토큰 2의 $Q$와 (토큰 1의 $K$, 토큰 2의 $K$)의 내적 값
아직 가공하지 않은 연관성 점수이다. 토큰 2의 Query는 토큰 1의 Key와 내적이 4.0으로, 자기 자신(2.0)보다 토큰 1에 더 강하게 반응한다.
3단계: 스케일링 ($\sqrt{d_k}$로 나누기)
$d_k = 2$ 이므로 $\sqrt{d_k} = \sqrt{2} \approx 1.414$ 이다.
\[\frac{QK^T}{\sqrt{d_k}} = \begin{bmatrix} \frac{1.0}{1.414} & \frac{0.0}{1.414} \\ \frac{4.0}{1.414} & \frac{2.0}{1.414} \end{bmatrix} \approx \begin{bmatrix} 0.707 & 0.000 \\ 2.828 & 1.414 \end{bmatrix}\]내적 값이 너무 커지지 않게 보정해서, softmax에서 확률이 한쪽으로 쏠려 기울기가 소실되는 일을 막는다.
4단계: 소프트맥스 적용 (가중치 확률화)
각 행별로 소프트맥스 함수 $\text{softmax}(x_i) = \frac{e^{x_i}}{\sum e^{x}}$를 적용한다.
- 1행 (토큰 1 기준)
- $e^{0.707} \approx 2.028$, $e^{0.000} = 1.000$
- 분모 합: $2.028 + 1.000 = 3.028$
- softmax 결과: $\left[\frac{2.028}{3.028}, \frac{1.000}{3.028}\right] \approx [0.67, 0.33]$
- 2행 (토큰 2 기준)
- $e^{2.828} \approx 16.911$, $e^{1.414} \approx 4.112$
- 분모 합: $16.911 + 4.112 = 21.023$
- softmax 결과: $\left[\frac{16.911}{21.023}, \frac{4.112}{21.023}\right] \approx [0.80, 0.20]$
softmax를 거친 어텐션 가중치 행렬은 다음과 같다.
\[A = \begin{bmatrix} 0.67 & 0.33 \\ 0.80 & 0.20 \end{bmatrix}\]- 토큰 1을 인코딩할 때: 자기 자신(토큰 1)의 정보를 67%, 토큰 2의 정보를 33% 반영한다.
- 토큰 2를 인코딩할 때: 토큰 1의 정보를 80%, 자기 자신(토큰 2)의 정보를 20% 반영한다.
점수가 합이 1인 비율로 바뀌어서, 각 토큰이 다른 토큰의 정보를 얼마씩 가져올지가 정해진다.
5단계: $V$ 행렬과의 행렬곱 (최종 출력 $Z$)
어텐션 가중치 행렬 $A$에 실제 정보가 담긴 $V$를 곱한다.
\[Z = A V = \begin{bmatrix} 0.67 & 0.33 \\ 0.80 & 0.20 \end{bmatrix} \begin{bmatrix} 0.5 & 1.5 \\ 2.0 & 0.0 \end{bmatrix}\]- 토큰 1의 최종 벡터 ($Z$의 1행)
- 토큰 2의 최종 벡터 ($Z$의 2행)
최종 출력 행렬 $Z$:
\[Z = \begin{bmatrix} 0.995 & 1.005 \\ 0.800 & 1.200 \end{bmatrix}\]각 토큰의 초기 벡터가 셀프 어텐션을 거치면서, 다른 토큰과의 관계 가중치만큼 정보가 섞인 문맥 벡터 $Z$로 바뀌었다.
멀티헤드 어텐션 (Multi-Head Attention)
어텐션을 한 번(Single-Head)만 쓰면 문장 안 단어들 사이의 연관성이 하나의 가중치로 뭉뚱그려진다. 한 단어가 주변 단어와 맺는 관계에는 문법적 관계, 위치 관계, 의미적 유사도처럼 여러 측면이 있는데, 어텐션 점수 하나로 이걸 다 담기는 어렵다.
그래서 transformer는 Query, Key, Value를 한 번만 계산하지 않고, h개의 서로 다른 가중치 행렬로 선형 투영(Linear Projection)해서 여러 개의 어텐션 헤드로 나눠 병렬로 계산한다. 이것이 멀티헤드 어텐션이다.
\[Q_i = Q W_i^Q, \quad K_i = K W_i^K, \quad V_i = V W_i^V \quad (i = 1, \dots, h)\] \[\text{head}_i = \text{Attention}(Q_i, K_i, V_i) = \text{softmax}\left(\frac{Q_i K_i^T}{\sqrt{d_k}}\right) V_i\]각 헤드는 서로 다른 표현 공간(Subspace)에서 따로 어텐션을 수행한다. 예를 들어 어떤 헤드는 주어-동사 같은 문법 관계를, 어떤 헤드는 대명사가 가리키는 대상을, 또 어떤 헤드는 멀리 떨어진 단어 사이의 연관성을 보도록 학습될 수 있다.
h개 헤드의 결과($\text{head}1, \dots, \text{head}_h$)는 이어 붙인 뒤 출력 가중치 행렬 $W^O$를 곱해 원래 차원($d{\text{model}}$)으로 되돌린다.
\[\text{MultiHead}(Q, K, V) = \text{Concat}(\text{head}_1, \text{head}_2, \dots, \text{head}_h) W^O\]원본 논문의 base 모델은 $d_{\text{model}} = 512$를 $h = 8$개 헤드로 나눠서, 헤드마다 $d_k = d_v = 512 / 8 = 64$차원으로 어텐션을 병렬 수행한다. 헤드당 차원을 줄였기 때문에 전체 연산량은 512차원에서 어텐션을 한 번 하는 것과 비슷하다.
피드포워드 네트워크(FFN), 잔차 연결 및 레이어 정규화
셀프 어텐션을 거친 벡터는 각 위치(토큰)마다 독립적으로 적용되는 Position-wise Feed-Forward Network(FFN)를 지난다.
어텐션이 토큰 사이의 정보를 섞는 역할이라면, FFN은 섞인 정보를 토큰별로 비선형 변환해서 더 풍부한 표현으로 바꾸는 역할이다.
\[\text{FFN}(x) = \max(0, x W_1 + b_1) W_2 + b_2\]FFN은 선형 변환 두 개와 그 사이의 ReLU로 이루어진다.
- 첫 번째 선형 레이어($W_1$)가 512차원 벡터를 2048차원($d_{ff} = 2048$)으로 늘린다.
- ReLU를 통과한다.
- 두 번째 선형 레이어($W_2$)가 다시 512차원으로 줄인다.
또 인코더의 모든 서브레이어(Multi-Head Attention, FFN)의 출력에는 잔차 연결(Residual Connection)과 레이어 정규화(Layer Normalization)가 붙는다.
\[\text{LayerNorm}(x + \text{SubLayer}(x))\]입력 $x$를 서브레이어 출력 $\text{SubLayer}(x)$에 그대로 더하는 잔차 연결은 기울기 소실을 막아 주기 때문에 레이어를 수십 층까지 깊게 쌓을 수 있고, 레이어 정규화는 학습을 안정시킨다.
디코더 구조와 크로스 어텐션
인코더가 입력 시퀀스를 해석해 문맥 표현을 만든다면, 디코더는 그 표현을 바탕으로 다음 토큰을 하나씩 생성한다.
디코더 레이어 하나는 세 개의 서브레이어로 이루어진다.
flowchart TB
    IN["타겟 시퀀스 입력 (Shifted Right)"] --> M
    subgraph DEC["디코더 레이어"]
        M["① Masked Multi-Head Self-Attention<br>미래 토큰 참조 방지 (Causal Masking: Score → -∞)"] --> AN1["Add & LayerNorm"]
        AN1 --> CA["② Encoder-Decoder Attention (Cross-Attention)<br>Query: 디코더 내부 이전 상태<br>Key & Value: 인코더의 최종 출력 벡터"]
        CA --> AN2["Add & LayerNorm"]
        AN2 --> FF["③ Position-wise Feed-Forward Network (FFN)"]
        FF --> AN3["Add & LayerNorm"]
    end
    ENC["인코더 최종 출력"] -- "Key, Value" --> CA
    AN3 --> OUT["Linear & Softmax<br>최종 출력 확률 분포"]
1. Masked Self-Attention
디코더의 셀프 어텐션은 인코더와 기본 동작이 같지만, 미래 토큰을 볼 수 없도록 마스킹(Causal Masking)이 추가된다.
예를 들어 세 번째 단어를 만들 때는 첫 번째와 두 번째 단어만 볼 수 있어야 하고, 네 번째 이후 단어를 미리 엿보면 안 된다. 그래서 어텐션 점수 행렬에서 현재 위치보다 뒤에 있는 위치의 점수를 $-\infty$로 바꾼다. 이 점수들이 softmax를 지나면 가중치가 정확히 0이 되어 미래 정보가 반영되지 않는다. 배치 안에서 문장 길이를 맞추기 위한 패딩 마스크도 같이 처리한다.
2. Encoder-Decoder Cross-Attention
디코더와 인코더를 이어주는 부분으로, 문장을 생성하는 각 위치에서 원문(인코더 출력)의 어디에 집중할지 정한다.
- Query(Q): 디코더의 직전 masked 어텐션 레이어 출력에서 만든다. (“지금 만들 단어에 어떤 정보가 필요한가?”)
- Key(K) & Value(V): 인코더의 최종 출력 벡터에서 가져온다. (“원문에는 어떤 정보가 있는가?”)
프랑스어 “Je vais à l’école”를 영어 “I am going to school”로 번역한다고 하자. 디코더가 “school”을 만들 차례가 되면, 디코더의 Query는 인코더가 “école”을 표현한 Key/Value 벡터에 높은 가중치를 준다. 기존 RNN 기반 seq2seq는 원문 전체를 고정 길이 벡터(Thought Vector) 하나로 압축해야 했는데, 이 병목이 해결된 것이다.
3. 피드포워드 네트워크와 출력층 (Linear & Softmax)
크로스 어텐션 뒤에 인코더와 같은 FFN을 거친 벡터는 선형 레이어를 지나 단어 사전(Vocabulary) 크기의 차원으로 늘어난다. 여기에 softmax를 적용해 각 단어가 다음에 올 확률로 바꾸고, 확률이 가장 높은 토큰을 골라 출력에 붙인다. 이 과정을 반복해서 문장을 만든다.
transformer의 실험 결과
transformer는 발표 당시 기계 번역 벤치마크에서 기존 신경망 구조들을 앞섰다.
기존 SOTA 모델보다 학습 시간과 컴퓨팅 자원은 적게 쓰면서 BLEU 점수는 더 높았다.
또 문장 길이가 N일 때 RNN은 N번의 순차 단계를 거쳐야 해서 계산 경로 길이가 $O(N)$이지만, transformer의 self attention은 어떤 두 단어 사이든 경로 길이가 $O(1)$이다. 단어 사이를 어텐션 한 번으로 직접 연결하니 장기 의존성(Long-range dependencies)을 배우기 쉽고 학습 속도도 빨라졌다.
영어 구문 분석(constituency parsing) 과제에서도 구조를 거의 바꾸지 않고 적용해 높은 F1 점수를 냈다. 시퀀스 처리에 순환 구조가 꼭 필요한 것은 아니라는 걸 보여준 결과이다.
Universal Transformer
transformer가 나왔을 때 일부에서는 순환 구조가 완전히 빠진 것을 두고, 단어 순서를 제대로 다루지 못하고 위치 인코딩이라는 임시방편(Hack)에 기댄다는 회의적인 시각이 있었다.
이런 우려를 반영해 2018년 Google 연구진은 transformer에 순환 구조를 다시 들여온 Universal Transformer(UT)를 제안했다.
- UT는 레이어를 위로 계속 쌓는 대신, 같은 어텐션+FFN 블록(Recurrent Block)을 모든 토큰에 대해 여러 타임스텝(T) 동안 반복 적용한다. (깊이 방향 재귀: Depth-wise Recurrence)
- 이 구조 덕분에 이론적으로는 시간과 메모리가 충분하면 일반적인 컴퓨터가 수행하는 모든 알고리즘을 흉내 낼 수 있는 ‘튜링 완결성’을 갖는다.
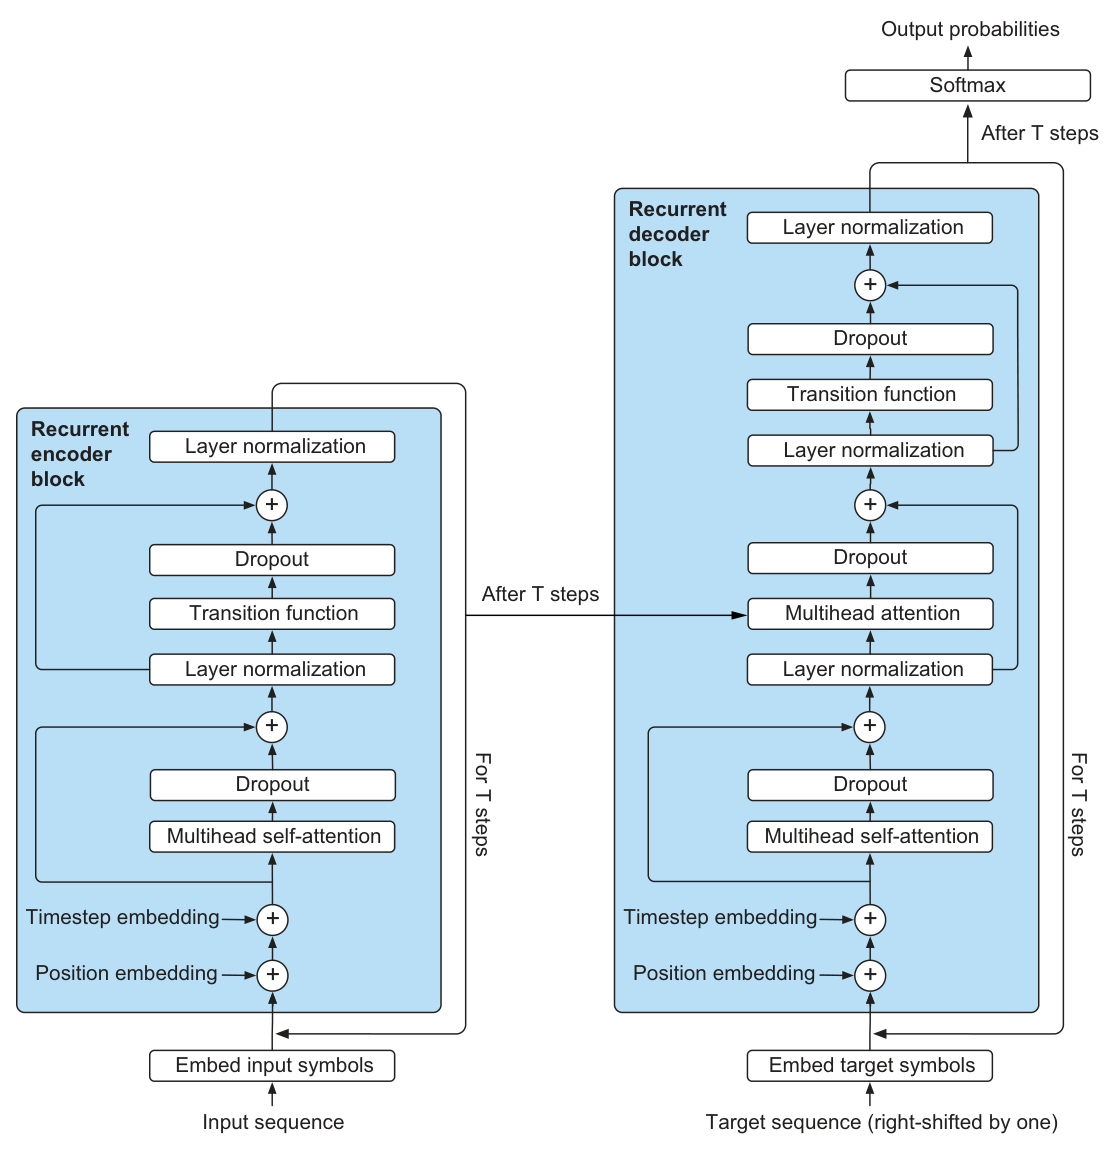
출처: Richard Heimann, Sutskever’s List (Manning), Figure 5.2 · 원 논문: Dehghani et al. (2018)
하지만 실제로는 표준 transformer보다 느렸고 성능 이점도 뚜렷하지 않았다. 복잡한 이론적 장점보다, 구조가 단순하고 데이터와 컴퓨팅을 많이 넣을수록 잘 확장되는(Scaling) 표준 transformer가 결국 이긴다는 흐름을 보여주는 사례가 되었다.
The Annotated Transformer와 구현의 대중화
transformer 논문의 개념은 명확했지만, Google이 처음 공개한 오픈소스 코드(Tensor2Tensor)는 내부 인프라 프레임워크와 단단히 엮여 있어서 외부 연구자나 개발자가 구조를 파악하고 직접 구현하기 상당히 까다로웠다.
이 장벽을 낮춘 것이 하버드 대학교 Alexander “Sasha” Rush 교수의 “The Annotated Transformer” 포스트이다.
- 논문의 수식, 섹션과 1대1로 대응되는 줄 단위 PyTorch 구현과 주석을 제공했다.
- 인코더-디코더 스택, 멀티헤드 어텐션, 위치 인코딩, 마스킹, 간단한 학습 루틴까지 400여 줄의 PyTorch 코드로 실제 동작하는 모델을 구현했다.
- 이 포스트로 transformer의 진입 장벽이 크게 낮아졌고, 이후 The Illustrated Transformer, The Annotated GPT-2, The Annotated Diffusion Model 같은 해설서와 실습 자료가 이어져 나왔다.
여담
세상을 바꾼 이 논문은 NeurIPS 2017 당시 구글의 논문이었는데도 구두 발표(Oral) 기회를 얻지 못하고 Poster와 짧은 Spotlight 세션으로 배정되었다.
구글은 transformer를 발표하고 1년쯤 뒤, 순환 구조를 버린 데 대한 이론적 불안감 때문인지 튜링 완결성을 갖춘 Universal Transformer(UT)를 내놓는 등 inductive bias 쪽에 미련을 두고 머뭇거렸다. 반면 OpenAI의 일리야 수츠케버(Ilya Sutskever)는 논문을 보자마자 “우리는 이제 transformer에 올인한다”고 말하고, 단순한 구조를 그대로 키우는 길을 택했다고 전해진다.
위에서 본 Tensor2Tensor는 내부 도구에 너무 묶여 있어 외부에서 읽기가 어려웠는데, Sasha Rush가 소설 The Annotated Alice에서 이름을 따와 400줄 남짓한 PyTorch 코드로 다시 구현한 The Annotated Transformer를 내면서 전 세계 연구자들에게 널리 퍼지게 되었다.
“X is All You Need” 밈도 이 논문에서 시작되었다. 이후 “… is All You Need”라는 제목의 논문이 수없이 쏟아졌다.
댓글 남기기