
RNN은 불합리할 정도로 유효하다 - 안드레 카파시
RNN의 불합리한 유효성
2015년 5월, 안드레이 카파시는 “The Unreasonable Effectiveness of Recurrent Neural Networks”라는 블로그 글을 올렸다. 요지는 이렇다. 다음에 올 글자 하나만 맞히도록 character 단위로 단순하게 학습시켰을 뿐인데, RNN이 문법과 문맥, 심지어 HTML이나 LaTeX 같은 문서 구조까지 지켜가며 글을 써 내려간다는 것이다.
2015년 당시의 분위기
그때만 해도 RNN 설명은 수식투성이라 입문하기가 만만치 않았다. 카파시는 수식 없이 설명과 코드, 실험 결과를 블로그에 풀어놓았고, 그 덕에 많은 사람이 RNN을 훨씬 쉽게 접하게 되었다.
실험은 character level 언어 모델이었다. 단어나 문장의 뜻은 알려주지 않고, 글자를 순서대로 읽히면서 다음 글자를 예측하게 한 것이다.
학습 데이터는 폴 그레이엄의 에세이, 셰익스피어 작품, 위키백과 문서, LaTeX 수학 문서, 리눅스 소스코드 등이었다.
“불합리할 정도로 유효하다”
카파시가 이렇게 표현한 건, 글자 순서만 배웠는데도 철자를 맞추는 수준을 넘어 문맥과 형식까지 꽤 그럴듯하게 흉내 냈기 때문이다.
실험 결과를 몇 가지만 보면 다음과 같다.
- 셰익스피어 대본을 학습시키니 인물 이름, 콜론, 줄바꿈 같은 대본 형식을 그대로 따라 대사를 만들었다.
- 위키백과와 LaTeX를 학습시키니 위키 마크업과 주석 틀을 잘 따랐고, 수식 기호와 구문도 LaTeX 문법에 맞게 썼다.
- 리눅스 코드를 학습시키니 C 코드의 들여쓰기, 변수 선언, 괄호 짝 맞추기까지 배워서 그럴듯한 코드를 뽑아냈다.
물론 생성물을 자세히 읽어보면 내용은 앞뒤가 안 맞고 할루시네이션도 많았다. 그래도 글자 단위에서 시작해 문법 구조와 문맥을 스스로 잡아내고 흉내 낸다는 점 자체가 당시에는 꽤 충격이었다.
RNN 구조 특징
이런 결과가 나온 이유는 RNN의 구조에 있다.
CNN 같은 일반적인 신경망은 이미지처럼 크기가 고정된 데이터를 받아 한 번에 결과를 내놓는다. 반면 RNN은 텍스트나 음성처럼 순서가 있는 시퀀스 데이터를 다룬다.
또 RNN에는 hidden state라는 기억장치가 있다. 새 글자(입력값)를 처리할 때마다, 지금까지 처리한 정보를 압축해 둔 hidden state를 같이 받아서 갱신한다.
예를 들어 “hello”를 만든다고 하자. 지금까지 들어온 글자가 “hell”이라는 기억(hidden state)이 있으니 다음 글자가 “o”일 것이라고 예측할 수 있다. 문맥이 유지되는 것이다.
앞 단계의 정보를 계속 이어 전달하는 이 구조 덕분에, 고정된 몇 개 단어만 보던 n-gram 같은 통계 모델의 한계를 넘어 앞의 맥락을 길게 끌고 가며 문장을 완성할 수 있었다.
카파시 블로그 글에 대한 논쟁
이 글은 개발자 커뮤니티에서 반응이 뜨거웠지만 비판도 있었다.
대표적으로 요아브 골드버그는 n-gram 같은 단순한 통계 모델도 데이터를 충분히 넣으면 RNN 못지않게 그럴듯한 텍스트를 만든다고 짚으면서, RNN이 대단한 지능을 가진 것처럼 오해하면 안 된다고 했다.
한편 이후 토마스 미콜로프 등의 연구에서는 데이터가 많아지면 RNN이 기존 통계 모델의 성능 한계를 확실히 넘어선다는 결과가 나왔다.
RNN 이해하기
RNN은 Recurrent Neural Network의 약자로, 문장, 음성, 시계열 같은 시퀀스 데이터를 다룰 때 현재 입력뿐 아니라 이전 시점의 정보까지 함께 반영하도록 만든 신경망이다. 내부에 기억장치 역할을 하는 hidden state가 있어서 과거의 문맥을 시간 순서대로 계속 넘겨줄 수 있다.
RNN 동작 방식
RNN은 시퀀스를 한꺼번에 처리하지 않고 순서대로 하나씩 처리한다. 일반적인 신경망은 입력을 넣으면 출력을 내고 끝이지만, RNN은 매 시점마다 자기 자신에게 돌아오는 내부 저장소, 즉 hidden state를 같이 쓴다.
- 이전 단계에서 만든 정보($h_{t-1}$)를 버리지 않고 남겨둔다.
- 새 입력($x_t$)이 들어오면 남겨둔 $h_{t-1}$과 결합한다.
- 결합한 결과로 새로운 정보($h_t$)를 만든다.
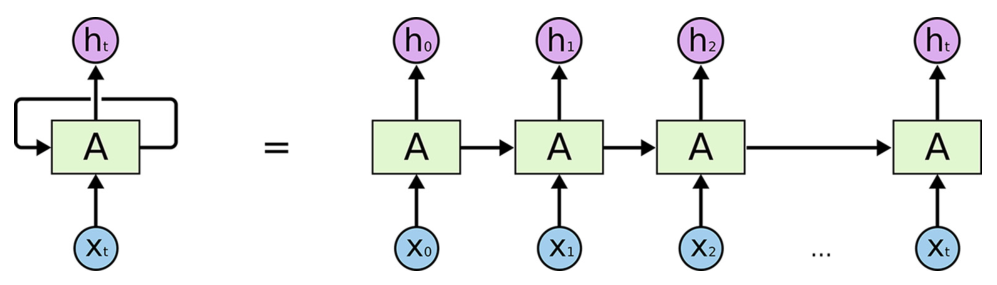
출처: Richard Heimann, Sutskever’s List (Manning), Figure 4.1 · 원 그림: Chris Olah, Understanding LSTM Networks (2015)
RNN 계산 순서
1단계: hidden state update
과거 정보와 현재 입력을 섞어서 새 기억을 만드는 단계이다.
\[h_t = \tanh(W_x x_t + W_h h_{t-1} + b)\]- $x_t$: 현재 들어온 입력값
- $h_{t-1}$: 직전 단계까지 쌓인 기억값
- $W_x$: 현재 입력에 곱하는 가중치
- $W_h$: 이전 기억에 곱하는 가중치
- $b$: 편향
- $\tanh$: 결과를 -1에서 1 사이로 눌러주는 함수
이렇게 현재 입력 $x_t$와 이전 기억 $h_{t-1}$이 합쳐져 새 hidden state $h_t$가 나온다.
2단계: 출력 계산
새로 만든 기억으로 출력을 내는 단계이다.
\[y_t = W_y h_t + b_y\]- $h_t$: 1단계에서 만든 새 기억값
- $W_y$: 출력 형태에 맞추기 위한 가중치
- $b_y$: 출력용 편향
- $y_t$: 최종 예측값
예시로 보면
입력이 3개 있다고 하자.
x1, x2, x3
RNN은 이걸 한꺼번에 처리하지 않고 이 순서대로 처리한다.
x1 -> x2 -> x3
각 시점의 hidden state는 다음 시점으로 넘어간다.
h0 -> h1 -> h2 -> h3
처음에는 이전 hidden state가 없으니 h0을 0으로 둔다. 첫 번째 입력 x1이 들어오면 \(h_1 = \tanh(W_x x_1 + W_h h_{0} + b)\) 를 계산해서 첫 번째 hidden state h1을 만든다. 이게 1단계(hidden state update)이다.
그다음 h1으로 출력을 계산한다. \(y_1 = W_y h_1 + b_y\)
이어서 x2가 들어오면 h1을 버리지 않고 그대로 써서 \(h_2 = \tanh(W_x x_2 + W_h h_1 + b)\) 를 계산하고, 이 h2로 \(y_2 = W_y h_2 + b_y\) 를 만든다.
이걸 끝까지 반복한다.
Hidden State
RNN에서 말하는 “기억”은 어딘가에 따로 저장해 두는 장치가 있다는 뜻이 아니다. hidden state $h_t$ 자체가 이전 입력들을 반영해서 계산된 벡터라는 뜻이다.
h1이 f(x1)이라면 h2는 f(x2, h1), h3는 f(x3, h2)가 되니, h3에는 x3, x2, x1의 정보가 모두 녹아 있다고 보면 된다.
가중치는 모든 시점에서 공유된다
$W_x$와 $W_h$는 현재 입력과 과거 정보를 각각 얼마나, 어떤 방식으로 반영할지 학습하는 가중치이다.
\[h_t = \tanh(W_x x_t + W_h h_{t-1} + b)\]식을 다시 보면 현재 정보와 과거 정보, 두 종류가 들어온다. 둘을 그냥 더하는 게 아니라 각각 다른 가중치를 곱한다.
\[\underbrace{W_xx_t}_{\text{현재 정보}} + \underbrace{W_hh_{t-1}}_{\text{과거 정보}}\]그리고 이 가중치($W_x$, $W_h$)는 모든 시점에서 똑같이 쓴다. \(h_1 = \tanh(W_xx_1 + W_hh_0+b)\)
\[h_2 = \tanh(W_xx_2 + W_hh_1+b)\]\(h_3 = \tanh(W_xx_3 + W_hh_2+b)\) 이유는 시퀀스 길이가 데이터마다 다르기 때문이다.
“나는 밥을 먹었다.”처럼 짧은 문장도 있고 “나는 오늘 친구와 함께 맛있는 밥을 먹었다.”처럼 긴 문장도 있다. 시점마다 다른 가중치($W_{x1}, W_{x2}, W_{x3} \dots$)를 쓰는 모델이라면, 짧은 문장에 맞춰 만든 가중치로는 더 긴 문장을 처리할 수 없다. 시점별 전용 가중치가 필요하니 최대 시퀀스 길이를 미리 정해야 하고, 그 길이를 넘는 입력은 계산 자체가 안 된다.
반대로 가중치를 하나로 고정해 모든 시점에서 공유하면, 단어가 4개든 7개든 상관없이 같은 공식을 계속 재사용하면 된다.
RNN의 문제점
모든 시점에서 같은 가중치($W_h, W_x$)를 반복해서 곱하며 hidden state를 갱신하는 이 구조는 Long-Term Dependency 문제를 일으킨다.
Long-Term Dependency 문제
시퀀스가 길어질수록 처음에 들어온 정보가 뒤로 갈수록 흐려지거나 왜곡되어서, 나중 시점의 예측에 영향을 못 주는 현상이다.
\[h_t = \tanh(W_x x_t + W_h h_{t-1} + b)\]RNN은 학습할 때 미래 시점의 오차에서 과거 시점으로 기울기(gradient)를 거꾸로 전파하는 시간 역전파(Backpropagation Through Time, BPTT)를 쓴다. 시간을 거슬러 올라갈수록 같은 $W_h$가 시점 수(T)만큼 계속 곱해진다.
flowchart RL
    L(["손실 L"]) -- "∂L/∂h<sub>T</sub>" --> hT["h<sub>T</sub>"]
    hT -- "× W<sub>h</sub>" --> hT1["h<sub>T-1</sub>"]
    hT1 -- "× W<sub>h</sub>" --> dots["⋯"]
    dots -- "× W<sub>h</sub>" --> h1["h<sub>1</sub>"]
이때 $W_h$의 크기에 따라 문제가 두 가지로 갈린다. Vanishing Gradient와 Exploding Gradient이다.
$W_h$가 1보다 작거나, $\tanh$의 미분값(0~1 사이)이 계속 곱해지면 시점이 멀어질수록 기울기가 0에 가까워진다. 결국 초반 시점($h_1, h_2$)의 가중치에는 기울기가 전달되지 않아 학습이 안 되는데, 이것이 Vanishing Gradient이다.
반대로 $W_h$가 1보다 크면 거슬러 올라갈수록 값이 거듭제곱으로 불어나 기울기가 폭발한다. 가중치 업데이트가 제대로 안 되고 학습이 불안정해지거나 아예 발산하는 것이 Exploding Gradient이다.
결국 RNN은 시퀀스가 조금만 길어져도 초기 정보 $x_1$을 끝까지 들고 가지 못하고 잊어버린다.
댓글 남기기