
LSTM
RNN의 한계
RNN은 이전 단계의 정보를 계속 넘겨받아 다음 단계의 출력에 반영하도록 만든 구조이다. 문제는 데이터가 길어질 때 생긴다.
데이터가 여러 단계를 지나는 동안 앞쪽 정보의 gradient가 계속 곱해지면서 0에 가까워진다. 앞에서 본 vanishing gradient이다.
그 결과 RNN은 바로 직전의 몇 단어(단기 정보)는 기억해도 문장 앞부분(장기 정보)은 잊어버린다. 예를 들어 문장 맨 앞 주어가 단수인지 복수인지에 따라 맨 뒤 동사의 형태가 정해지는 경우를 RNN은 잘 처리하지 못한다. (e.g. The cat (that lived in the small village with three other pets for ten long years) was sleeping. 에서 pets나 years에 끌려서 was 대신 were를 쓰는 실수가 생길 수 있다.)
반대로 Exploding Gradient가 생길 수도 있다.
Cell State
LSTM은 이 장기 기억 문제를 풀려고, RNN의 hidden state와 별개로 Cell State라는 정보 전달 경로를 하나 더 두었다.
Cell State는 정보가 흐르는 메인 길이자 장기 메모리이다. 복잡한 연산을 거의 거치지 않고 시퀀스를 따라 일직선으로 흐르기 때문에, 앞 단계의 중요한 정보가 크게 변하지 않은 채 먼 뒤쪽까지 전달될 수 있다.
Hidden state는 단기 메모리이다. 현재 입력 x_t와 걸러진 cell state C_t를 반영해 당장의 출력을 만들고, 그 값을 다음 시점으로 넘긴다.
Gate 구조
LSTM은 Cell State에 무엇을 더하고 무엇을 지울지 조절하려고 세 가지 Gate를 쓴다.
Gate는 sigmoid 레이어와 곱셈 연산으로 이루어져 있다. sigmoid가 0~1 사이 값을 내놓으니, 정보를 몇 퍼센트 통과시킬지를 정하는 셈이다.
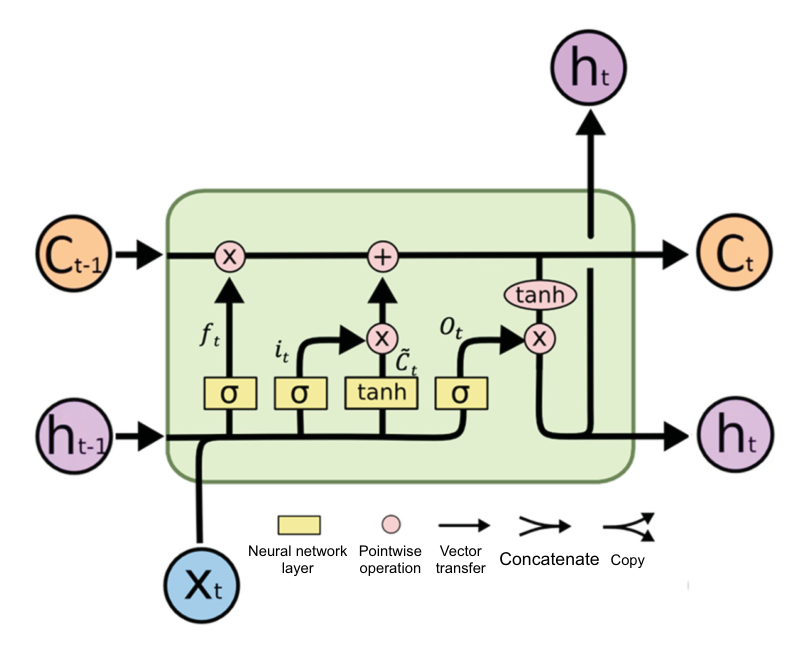
출처: Richard Heimann, Sutskever’s List (Manning), Figure 4.2 · 원 그림: Chris Olah, Understanding LSTM Networks (2015)
- Forget Gate
Forget Gate는 이전 Cell State에서 무엇을 버릴지 정한다.
\[f_t = \sigma(W_f \cdot [h_{t-1}, x_t] + b_f)\]- $x_t$: 현재 시점의 입력 벡터
- $h_{t-1}$: 이전 시점의 hidden state(단기 기억) 벡터
- $W_f, b_f$: forget gate의 가중치 행렬과 편향
- $\sigma$: 결과를 0과 1 사이로 바꿔주는 sigmoid 함수. $f_t$의 각 요소가 0에 가까우면 이전 정보 $C_{t-1}$을 버리고, 1에 가까우면 그대로 보존한다.
- Input Gate와 후보 셀 상태 ($\tilde{C}_t$)
Input Gate는 새로 들어온 정보 중 무엇을 Cell State에 저장할지 정한다.
\[i_t = \sigma(W_i \cdot [h_{t-1}, x_t] + b_i)\] \[\tilde{C}_t = \tanh(W_c \cdot [h_{t-1}, x_t] + b_c)\]- $i_t$ (input gate): 현재 입력 중 얼마나 저장할지(0~1)를 정한다.
- $\tilde{C}_t$ (후보 셀 상태): 이번 시점에 Cell State에 더해질 수 있는 새 후보 값이다. $\tanh$ 때문에 -1과 1 사이 값이 된다.
정리하면, sigmoid 레이어가 어떤 정보를 업데이트할지 고르고, tanh 레이어가 현재 입력을 바탕으로 Cell State에 추가할 후보 값을 만든다. 이 둘을 곱해서 저장할 정보의 양과 내용을 정하고, 이걸 Forget Gate를 거친 기존 Cell State에 더한다. 이렇게 Cell State가 업데이트된다.
- 셀 상태 업데이트 (Cell State Update, $C_t$)
이전 장기 기억 $C_{t-1}$은 forget gate로 걸러내고, 새 후보 정보 $\tilde{C}_t$는 input gate로 걸러낸 다음, 둘을 더해서 새 장기 기억 $C_t$를 만든다.
\[C_t = f_t \odot C_{t-1} + i_t \odot \tilde{C}_t\]- $\odot$: 요소별 곱셈(element-wise multiplication)
- $f_t \odot C_{t-1}$: 이전 셀 상태에서 잊기로 한 부분을 걸러내고 남은 정보
- $i_t \odot \tilde{C}_t$: 이번에 새로 저장하기로 한 정보
여기서 핵심은 덧셈(+)이다. 덧셈 구조 덕분에 gradient가 시점을 거슬러 전파될 때도 크게 줄어들지 않고 흘러갈 수 있어서, vanishing gradient 문제가 훨씬 완화된다.
- Output Gate와 hidden state 업데이트 ($h_t$)
업데이트된 장기 기억 $C_t$로부터 현재 시점의 출력이자 다음 시점으로 넘길 hidden state $h_t$를 계산한다.
\[o_t = \sigma(W_o \cdot [h_{t-1}, x_t] + b_o)\] \[h_t = o_t \odot \tanh(C_t)\]- $o_t$ (output gate): 장기 기억 $C_t$ 중 얼마를 현재 출력으로 내보낼지 정하는 값(0~1)이다.
- $\tanh(C_t)$: $C_t$를 -1과 1 사이로 맞춰준다.
이 값에 output gate $o_t$를 곱하면 현재 시점의 hidden state $h_t$가 나오고, 이 값이 현재 예측과 다음 시점의 입력에 쓰인다.
댓글 남기기