
Deep Speech 2
Dario Amodei와 Andrew Ng는 2014년 무렵 중국 기업 바이두의 실리콘밸리 연구소에서 일했다. 다리오 아모데이 등이 만든 Deep Speech 2(DS2)는 복잡하게 나뉘어 있던 기존 음성 인식 시스템을 하나의 딥러닝 구조로 합친 대규모 음성 인식 모델이다. AlexNet이 GPU와 대용량 데이터로 computer vision의 판을 바꿨듯이, DS2는 음성 인식에서도 대규모 종단간(End-to-End) 딥러닝이 기존의 다단계 시스템보다 낫다는 걸 보여주었다.
아키텍처
DS2는 음성 신호를 받아 곧바로 텍스트로 바꾼다.
기존 음성 인식 시스템은 사람이 언어학 규칙에 따라 만든 ‘발음 사전(Phonetic dictionary)’이 꼭 필요했다. 발음 사전은 단어의 발음을 기호로 정의한 것인데, 언어나 방언, 발음 변형마다 새로 만들어야 해서 손이 많이 가고 오류도 잦았다. DS2는 이 발음 사전을 없애고, 오디오 특징값에서 문자로 바로 매핑하는 법을 학습했다.
또 기존 시스템은 음성 데이터의 각 프레임이 정확히 어떤 단어에 해당하는지 맞춰주는 ‘프레임 단위 정렬’ 작업이 필요했다. DS2는 Connectionist Temporal Classification(CTC)을 대규모로 적용해서, 사전 정렬 없이 음성 시퀀스와 텍스트 시퀀스를 직접 연결해 학습할 수 있게 했다.
내부 동작을 순서대로 보면 이렇다. 입력 오디오는 먼저 주파수 변화를 시각화한 Spectrogram으로 바뀐다. 합성곱(Convolutional) 레이어가 이 spectrogram을 훑으며 배경 소음이나 톤 변화 같은 국소적 특징을 뽑는다. 그 특징은 여러 층의 순환 계층(Recurrent Layer)을 지나면서 시간에 따른 음성의 흐름과 맥락을 따라간다. 마지막으로 완전 연결 계층(Fully connected layer)을 거쳐, 영어는 연속된 두 글자 조합을, 중국어는 글자 하나를 출력한다.
실시간 서비스를 위해 DS2에는 두 가지 구조적 기법이 들어갔다.
첫째는 Row convolution(행 합성곱)이다. 과거와 미래 문맥을 모두 보는 양방향 RNN은 정확도가 높지만 미래 음성이 들어올 때까지 기다려야 해서 실시간 스트리밍에 쓸 수 없다. DS2는 단방향 RNN의 출력 위에, 좁은 시간 범위만 보는 행 합성곱 레이어를 얹었다. 미래의 아주 짧은 구간만 참조하게 해서, 스트리밍에서도 지연을 낮게 유지하면서 정확도를 확보했다.
둘째는 Stride(보폭)와 Bigram(글자 조합) 출력이다. 초기 합성곱 계층에서 시간 축 보폭을 넓혀 데이터를 압축하면 뒤따르는 순환 계층이 처리할 시간 단계가 크게 줄어든다. 이때 정보 손실을 막으려고 영어 모델은 글자 하나 대신 두 글자 조합을 한 번에 예측하게 했고, 덕분에 연산 효율과 메모리 사용량이 많이 좋아졌다.
여기에 시퀀스 단위 배치 정규화(sequence-wise batch normalization)도 적용했다. 배치 단위로 입력의 평균과 분산을 정규화해서, 깊은 순환 신경망의 학습을 안정시키고 수렴도 빠르게 했다.
학습 기법
DS2는 대규모 데이터와 컴퓨팅 자원을 제대로 쓰려고 여러 GPU를 동시에 쓰는 Data parallelism(데이터 병렬화)을 구축했다. 8~16개의 GPU에 데이터를 나눠 계산하고 gradient를 동기화하는 방식이다. 표준 통신 프로토콜 대신 GPU끼리 직접 데이터를 주고받는 All-reduce 연산을 직접 만들었고, 이것만으로 학습 속도가 2.5배 빨라졌다.
추론에서는 기존 32비트 단정밀도 대신 16비트 반정밀도(FP16) 연산을 썼다. 인식 정확도는 거의 그대로인 채 메모리 사용량이 절반으로 줄고 추론 처리량은 약 2배가 되었다. 지금은 흔해진 양자화(Quantization)와 저정밀도 연산의 초기 사례라고 볼 수 있다.
학습 초반의 안정성을 위해 SortaGrad라는 커리큘럼 학습 기법도 만들었다. 첫 번째 Epoch에서는 오디오를 길이가 짧은 순서대로 정렬해서 넣는다. 짧고 단순한 음성부터 배우게 하면 초기 수치 불안정이 줄고 수렴이 안정된다.
또 학습 데이터의 약 40%에 인위적인 배경 소음을 섞는 Data augmentation도 썼다. 다양한 소음 환경에서도 핵심 특징을 찾아내도록 일반화 성능을 높이려는 것이다.
이런 기법들을 바탕으로 DS2는 영어와 중국어 음성 각각 약 1만 시간으로 학습되었다. 연구진은 학습 데이터가 10배 늘 때마다 단어 오류율(WER)이 상대적으로 약 40%씩 줄어드는 경향을 발견했다. 깨끗한 음성에서는 크라우드소싱으로 모은 일반인 평가자보다 오류율이 낮았다. 다만 소음이 심하거나 억양이 강한 환경에서는 여전히 사람을 따라가지 못했다.
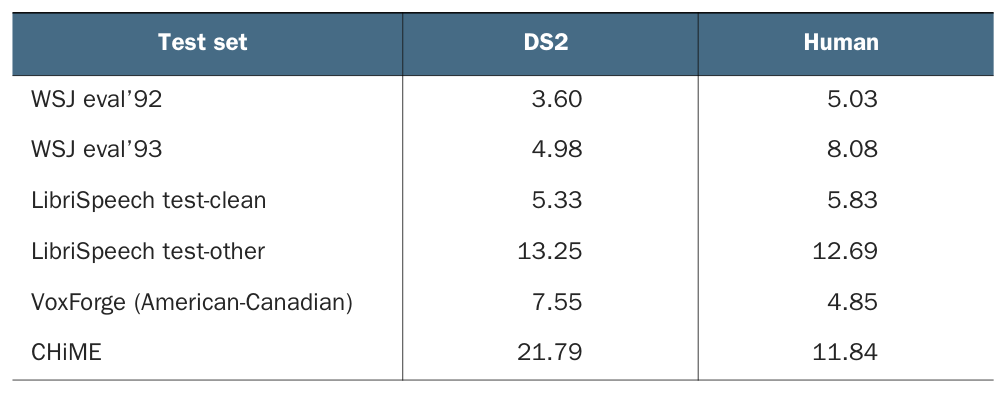
출처: Richard Heimann, Sutskever’s List (Manning), Table 4.1 · 원 논문: Amodei et al. (2015)
언어 모델과 디코딩
DS2는 파라미터가 최대 1억 개에 달해 기기 안에서 직접 돌리기에는 무거웠고, GPU 서버 기반의 클라우드 서비스로 배포되었다.
실시간 추론 효율을 높이려고 “Batch dispatch” 기법을 썼다. 여러 사용자의 요청이 동시에 들어오면 2~4개씩 작은 배치로 묶어 처리해서, GPU 메모리 대역폭 낭비를 줄이고 평균 50~70밀리초의 낮은 지연 시간을 달성했다.
음성 모델의 출력을 텍스트로 바꿀 때는 외부 언어 모델과 결합한 Beam search 디코딩을 사용한다. 확률이 가장 높은 단어 하나만 고르는 Greedy search는 빠르지만 전체 문맥을 놓치기 쉽다. Beam search는 유망한 문장 후보를 일정 개수 유지하면서, 음성 모델의 점수와 문맥상 자연스러움을 평가하는 언어 모델의 점수를 합산해 최종 문장을 고른다.
flowchart LR
    A["입력 오디오"] --> B["Spectrogram"]
    B --> C["합성곱 레이어"]
    C --> D["순환 레이어<br>+ Row convolution"]
    D --> E["완전 연결 레이어<br>+ CTC 출력"]
    E --> F["Beam search 디코딩"]
    LM["외부 언어 모델"] --> F
    F --> G["최종 텍스트"]
후보를 너무 많이 탐색하면 연산이 병목이 되기 때문에 Heuristic pruning도 넣었다. 영어 디코더는 매 단계 상위 500개, 중국어 디코더는 상위 200개 후보만 남기고 나머지는 버린다. 변환 정확도는 유지하면서 탐색량은 크게 줄었다.
영향
DS2는 단순한 음성 인식 모델이라기보다, 대규모 데이터와 컴퓨팅 자원, 알고리즘을 결합하면 성능이 얼마나 확장되는지를 수치로 보여준 사례이다. 학습 시간을 최대 7배 줄여서 몇 주 걸리던 실험을 며칠 단위로 만들었고, 언어가 바뀌어도 구조를 거의 바꾸지 않고 영어와 중국어 모두에서 좋은 성능을 냈다.
다만 완전한 종단간 구조라고 하기에는 한계도 있었다. Beam search 단계에서 외부 언어 모델에 의존했기 때문에, 신경망 혼자 음성 인식의 모든 문제를 푼 것은 아니었다. 이후 transformer와 conformer 아키텍처가 나오고 Byte-Pair Encoding(BPE) 같은 유연한 토큰화가 도입되면서 DS2의 세부 기술 일부는 대체되었다. 그래도 대용량 데이터 기반의 종단간 학습, CTC 기반 시퀀스 학습, 합성곱 프론트엔드, 실시간 배포를 고려한 엔지니어링은 지금의 음성 인식 시스템에도 이어지고 있다.
엔지니어링 패러다임의 전환
2010년대 AI 연구는 수식과 이론의 새로움을 중시하던 방식에서, 대규모 시스템과 엔지니어링을 합쳐 실제 문제를 푸는 쪽으로 옮겨가기 시작했다. DS2는 그 변화를 보여주는 대표적인 연구이다.
DS2가 나왔을 때 학계 일부와 학회(ICML 2016) 리뷰어들은 이 논문에 근본적으로 새로운 알고리즘이 없고 기존 기술을 대규모로 확장해 구현한 것뿐이라며, ‘순수 엔지니어링’이나 ‘무력(Brute force)으로 얻은 성과’라고 비판했다.
하지만 일리야 수츠케버(Ilya Sutskever) 같은 연구자들은 AI의 큰 도약이 참신한 아이디어만으로 오는 게 아니라고 보았다. 검증된 기술을 깊이 이해하고, 그걸 대규모 데이터와 최적화된 컴퓨팅 시스템 위에서 안정적으로 돌리고 배포하는 엔지니어링에서 나온다는 것이다. 2~3명의 작은 팀이 아이디어를 내던 예전과 달리, Deep Speech 2(저자 34명)나 AlphaGo(저자 20명)처럼 많은 인원이 협력해 정교한 시스템을 만드는 연구가 AI 발전의 중심이 되었다.
Deep Speech 2는 이론과 구현 사이의 간극을 줄이고, 대규모 컴퓨팅 인프라와 제품 중심 엔지니어링이 AI 성능 향상에 얼마나 중요한지 보여준 이정표라고 할 수 있다.
댓글 남기기